2020年7月30日星期四

胃癌年轻化!院士提醒:这张表超过12分,尽快去做胃镜了

不碰烟酒 27岁女士查出胃癌晚期

据《杭州日报》,2019年10月份,27岁的张女士出现阵发性中上腹胀痛,一开始她并没在意,一个月后她腹痛更频繁,且痛感加重,这才去医院就诊,胃镜检查结果显示:胃低分化腺癌。

张女士上网搜索时看到,有人说得癌开刀死得更快,所以她拒绝了手术,自行回家治疗。

今年1月,她的腹痛、腹胀症状越来越严重,肚子也越来越大,吃东西都咽不下,她才再次到医院就诊。

而这次,消息更坏,她的胃癌已发展到晚期,且肿瘤细胞扩散至腹膜和盆腔,已错过最佳治疗时机。


近几年,癌症好像是换了一种"口味",抛弃了中老年,找上了20-30岁年轻人,这个年纪,可以说是一生中最美好的年纪,最大的可能也多出现在这阶段,可有很多人却只能用来和癌症做斗争。所以,为了避免这种情况再大规模发生,我们一定要引起重视,提前设防,定期体检,尤其是胃癌的高危人群。

为什么胃癌逐步年轻化?

根据Globocan 2018数据显示,我国每年最高发的癌症分别是肝癌、肺癌、胃癌,其中,胃癌排行老三,年新发病人数45.6万,死亡人数39.0万,换算一下,也就是说每1-2分钟就有一位国人因为胃癌死亡,可见其发病率以及致死率有多恐怖。不仅如此,本来胃癌,在中年最为多见,这几年却越来越趋于年轻化。究其原因主要是还是和年轻的一些不良生活习惯有关。

熬夜,可以说是年轻人身上的一个标签,熬不了夜就说明老了,但是熬夜的后果却没人在乎,它可导致内分泌以及免疫系统出现紊乱,为癌症的发生埋下隐患。

再加上很多人熬夜的时候会有吃夜宵的习惯,而夜间肠胃如果得不到修复,粘膜不能及时修复,且食物滞留在胃里,可刺激胃液大量分泌,时间久了,就容易引起胃粘膜的糜烂、溃疡,严重者可导致胃癌的出现,尤其是吃一些油炸、烧烤、煎制、腊制食品,风险更大。

此外,吸烟饮酒,也可提升胃癌的患病风险。而吸烟、饮酒可以说是已经成为了现代年轻人生活乃至工作与交际的一种重要手段,但是烟当中有尼古丁、一氧化碳、烟焦油、苯并芘、二甲基亚硝胺、酚类化合物等多种致癌物质和促癌物质,这些物质可直接刺激胃粘膜,引起胃癌,而酒精,尤其是烈性酒,又会刺激胃黏膜,损伤黏膜组织,促进致癌物质的吸收,所以如果两者都接触了,胃癌找上门也是意料之内的事。

还有就是,很多年轻人都想趁着年轻多拼一拼,所以在生活中也不是很注意,早餐经常不吃,晚餐又吃得很多,很多时候为了赶时间,又是两口当一口吃,而这些行为对肠胃的伤害都是很大的,可为胃癌的发生创造条件。

所以,想要远离胃癌,年轻人应注意改正上述不良的生活方式,并在日常生活中密切注意胃癌的预警信号。

胃癌早期症状不明显

北京肿瘤医院的主任医师季加孚教授表示:胃癌早期症状虽然比较具有隐蔽性(80%没有症状),但是只要你多留意,还是能发现一些蛛丝马迹的,如食欲不振、早饱、腹部不适、恶心呕吐等,不过由于这些症状和胃炎、胃溃疡等胃病容易相混淆,所以容易被忽视。

这里提醒大家:要是之前胃一直是好好的,没有什么胃病历史,但是这段时间却总是出现腹胀、腹痛等上腹不适症状,原因不详,尤其是经过常规的治疗没有效果的;或者之前有胃溃疡等胃病历史,但是疼痛的性质以及规律产生了变化,而且一天比一天严重的人群,则要警惕胃癌,及时去医院检查。

早做检查,揪出胃癌

胃癌早期靠自主发现比较难,所以只能依靠检查。而一般的检查比如b超、ct、化验等,对早期胃癌的诊断都比较难,所以,胃镜多作为首选。

中山大学附属第六医院主任彭俊生表示:胃镜检查可以将病灶部位放大数倍,让医生可以更清晰看到胃部的具体情况,如侵犯胃壁的深度、周围淋巴结是否肿大或者转移,从而为医生诊断以及后续制定治疗方案提供准确的依据。不过胃镜的筛查方式有很多,包括无痛下的高清电子胃镜、超声、放大、染色胃镜等,所以,具体采取哪种还需要因人而定。我们要做的是发现可疑症状,及时去医院,剩下的医生会安排。

那么哪些人需要做胃镜检查?

中国工程院院士李兆申教授为了帮助大家了解哪些人需要做胃镜,特发起一份胃癌评分表,大家可以根据评分结果做判断,详情如下图:

图源:39健康网

此外,浙江省中医院消化内科专家吕宾教授也给出了建议,表示:年龄超过40岁;家里有胃癌病患史,尤其是直系亲属;饮食不规律,老吃一些腌制、油炸、烧烤、高盐类的食物;有胃溃疡、慢性胃炎病史者;幽门螺杆菌感染者;如果符合上述这些任意一个条件,都最好是一年进行一次胃镜检查。

胃癌发病率高,治疗难度大,所以平时要多关注自身健康,发现可疑症状,及时进行胃镜检查,尤其是一些胃癌的高危人群,更要引起重视,这样才能减少胃癌给我们带来的伤害。

参考资料:

[1]《20多位高危人群做胃镜 不是胃癌就是有癌前病变》.钱江晚报.2018-10-30

[2]《20多岁就患胃癌?疑病尽快胃镜筛查》.广州日报.2018-08-12

[3]《一文探究:为何全球胃癌一半在中国?》.宣晟远程会诊.2018-01-30

[4]《80%早期胃癌没有症状》.人民网.2003-10-09

胃癌年轻化!院士提醒:这张表超过12分,尽快去做胃镜了terapeakpat备战2016!快速启动亚马逊卖家注意!德国VAT的"火"烧到法国,还带上了西班牙!Sluuf思鹿网2019年免费站外推广官方解答:英国脱欧对卖家欧盟商标的影响以及相关法律问题江西婺源旅游价格多少江西婺源旅游大约多少钱江西婺源旅游大约多少钱

Ubuntu安装Cloudera Manager以及CDH5.15.2

一、机子分配

注意,本安装教程是在真机上进行,而非虚拟机。另,此次搭建主要的目的是搭建测试环境,让Hadoop各组件能够运作起来即可,完成搭建后,将用小数据量进行相关数据的计算与测试。线上环境将会使用阿里云主机。

以下是四台真机配置:

机子内网IP地址

主机名

内存大小

磁盘大小

CPU

192.168.0.29

bigdata01(主)

8GB

2T

1个物理CPU,4核

192.168.0.133

bigdata02(从)

8GB

500GB

1个物理CPU,2核

192.168.0.135

bigdata03(从)

8GB

500GB

1个物理CPU,2核

192.168.0.115

bigdata04(从)

8GB

500GB

1个物理CPU,2核

根据机子的配置,建议Hadoop的NameNode放在29这台机子上,配置高可用的话,NameNodeStandby放在除29以外任意一台机子均可,DataNode四台机子都要配。其它组件如何放置,后续会说到。


Tips:

在linux系统环境下,查看机子的内存大小命令:cat /proc/meminfo |grep MemTotal


查看机子的硬盘大小:fdisk -l | grep Disk


查看机子的CPU情况:

有两个公式可以记一下:总核数 = 物理CPU个数 * 每颗物理CPU的核数;

总逻辑CPU数 = 物理CPU个数 * 每颗物理CPU的核数 * 超线程数

查看物理CPU个数:cat /proc/cpuinfo| grep "physical id"| sort| uniq| wc -l

查看每个物理CPU的核数:cat /proc/cpuinfo| grep "cpu cores"| uniq

查看逻辑CPU的个数:cat /proc/cpuinfo| grep "processor"| wc -l


二、下载相关文件1、ubuntu系统

> 关于操作系统的选择,其实区别不大,这种级别的问题,对我这种水平的人,不太能够感知得到,当然会继续努力,去感知操作系统级别的问题。

2、cloudera manager相关下载

先下载好来,然后传到各个节点上去,不然安装过程中下载,速度慢得让你分分钟想砸键盘。

tar包下载:

https://archive.cloudera.com/cm5/cm/5/cloudera-manager-xenial-cm5.15.2_amd64.tar.gz


parcles下载:


下载的tar包,包含了cloudera manager server,cloudera manager daemons,cloudera manager agents。

parcles包则是CM特有的包格式,安装的各个组件就是从parcles里面取出来的。


三、系统环境的设置1、root用户的设置(四个节点都要)

ubuntu系统在刚安装完成后,root用户默认不被启用,也没有密码,因此需要给root用户设置一个登陆密码,还要设置root用户允许ssh登陆,这样会方便我们进行软件的安装。

给root用户设置密码:sudo passwd root

开启root用户ssh远程登陆权限:sudo vi /etc/ssh/sshd_config,将文件中的PermitRootLogin prohibit-password 改为 PermitRootLogin yes

要使修改的配置生效,需要重启ssh服务:service ssh restart

设置好了之后,登录root用户,后面都是用root用户操作了:su root

2、修改hosts文件(四个节点都要)

命令:vim /etc/hosts

将ip和主机名添加到文件末尾:

注意ip和主机名修改为你自己的。

3、免密登录ssh设置(四个节点都要)

这一步很重要,不然在安装CM的过程中会出错,一定要完成这一步。

首先,在每个节点上分别生成密钥

命令:ssh-keygen -t rsa

一路回车,结束后,在/root/.ssh文件夹中,会有id_rsa,id_rsa.pub两个文件。


每个节点都生成密钥成功后,然后我们把每个节点的id_rsa.pub文件中的内容,集中到一个名为authorized_keys文件中,然后把这个文件分别传送到各节点的.ssh文件夹中,这样我们就可以在任意节点使用ssh命令免密登录到别的节点上去。

最终,.ssh文件夹中,我们可以看到以下几个文件:

试试效果:

可以看到,这里并没有提示要求我们输入密码登录到bigdata02机子上。

4、安装jdk1.8(四个节点都要)

安装包已经下载好了,就在之前已经下载好的cm6.3.0-ubuntu1604.tar.gz这个包里。

将包上传到机子上,之后使用命令:tar -zxvf cm6.3.0-ubuntu1604.tar.gz,解压。

java安装包在路径:/cm6.3.0/pool/contrib/o/oracle-j2sdk1.8

注意这里是一个deb包,我们需要使用dpkg命令进行包的安装。

命令:dpkg -i oracle-j2sdk1.8_1.8.0+update181-1_amd64.deb

默认的安装路径为:/usr/lib/jvm/java-8-oracle-cloudera。


接下来配置jdk的全局环境变量

编辑 /etc/profile文件:vim /etc/profile

在文件末尾加上下面的代码:

export JAVA_HOME=/usr/lib/jvm/java-8-oracle-cloudera

export JRE_HOME=${JAVA_HOME}/jre

export CLASSPATH=.:${JAVA_HOME}/lib:${JRE_HOME}/lib

export PATH=${JAVA_HOME}/bin:$PATH

加入完成后,要使全局变量生效,使用命令:source /etc/profile

之后,输入:java -version,出现下面的提示,则说明安装成功了:

5、安装ntp(四个节点都要)

安装ntp包的目的是,为了保障各节点的时间能够同步,否则安装CDH过程中,会出现时间不同步的错误。

使用命令:apt-get install ntp 进行安装

使用命令:service ntp start 启动服务

6、安装mysql数据库(主节点需要,其它节点不需要安装)

使用命令安装:apt-get install mysql-server

安装完成后,修改一下配置文件:vim /etc/mysql/mysql.conf/mysqld.cnf

在【mysqld】下,添加:

lower_case_table_names=1

default-time_zone = '+8:00'

skip_ssl

重启mysql:service mysql restart

7、将下载的parcle文件放到主节点的目录下

将parcle文件上传到主节点目录,可以方便后续CM安装parcle,提高安装速度。

8、修改swappniness的值(四个节点都要)

根据cloudera manager的建议,将值设定为10

命令:echo 10 > /proc/sys/vm/swappiness

四、测试配置好的环境1、测试各节点是否网络通畅

ping bigdata01

ping bigdata02

ping bigdata03

ping bigdata04

2、测试各节点免密登录

ssh bigdata01

ssh bigdata02

ssh bigdata03

ssh bigdata04

都不需要输入密码,直接能够登录上,说明此项配置成功


五、安装Cloudera Manager并启动Server以及Agent1、文件操作(主节点上操作)

首先解压到/opt/文件夹下:

tar zxvf ~/cloudera-manager-xenial-cm5.15.2_amd64.tar.gz -C /opt/

然后在opt文件夹下,再创建以下几个文件夹:

mkdir /opt/cloudera /opt/cloudera/parcels /opt/cloudera/parcel-repo

剪切过去:

mv ~/CDH-5.15.2-2.cdh5.15.2.p0.3-xenial.parcel.sha1 /opt/cloudera/parcel-repo/CDH-5.15.2-1.cdh5.15.2.p0.3-xenial.parcel.sha

剪切过去:

mv ~/CDH-5.15.2-2.cdh5.15.2.p0.3-xenial.parcel /opt/cloudera/parcel-repo/CDH-5.15.2-1.cdh5.15.2.p0.3-xenial.parcel

剪切过去:

mv ~/manifest.json /opt/cloudera/parcel-repo/manifest.json

删除压缩包:

rm -rf ~/cloudera-manager-xenial-cm5.15.2_amd64.tar.gz

2、添加Mysql驱动(主节点上操作)

cp /usr/share/java/mysql-connector-java.jar /opt/cm-5.15.2/share/cmf/lib/mysql-connector-java.jar

3、创建数据库(主节点上操作)

这里创建的数据库,是用来存放各个大数据组件的元数据的。

这里数据库已经配置好了远程root可以登录,因此在windows电脑上,使用Navicate连接数据库。在Navicate里之行下面的数据库创建语句:

CREATE DATABASE scm DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

GRANT ALL ON scm.* TO 'scm'@'%' IDENTIFIED BY '123456';

CREATE DATABASE amon DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

GRANT ALL ON amon.* TO 'amon'@'%' IDENTIFIED BY '123456';

CREATE DATABASE rman DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

GRANT ALL ON rman.* TO 'rman'@'%' IDENTIFIED BY '123456';

CREATE DATABASE hue DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

GRANT ALL ON hue.* TO 'hue'@'%' IDENTIFIED BY '123456';

CREATE DATABASE sentry DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

GRANT ALL ON sentry.* TO 'sentry'@'%' IDENTIFIED BY '123456';

CREATE DATABASE metastore DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

GRANT ALL ON metastore.* TO 'hive'@'%' IDENTIFIED BY '123456';

CREATE DATABASE nav DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

GRANT ALL ON nav.* TO 'nav'@'%' IDENTIFIED BY '123456';

CREATE DATABASE navms DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

GRANT ALL ON navms.* TO 'navms'@'%' IDENTIFIED BY '123456';

CREATE DATABASE oozie DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci;

GRANT ALL ON oozie.* TO 'oozie'@'%' IDENTIFIED BY '123456';


4、创建SCM数据库(主节点上操作)

命令:/opt/cm-5.15.2/share/cmf/schema/scm_prepare_database.sh mysql scm scm

5、修改Agent配置(主节点上操作)

命令:vim /opt/cm-5.15.2/etc/cloudera-scm-agent/config.ini

修改server_host=localhost,改为server_host=192.168.0.29

6、复制到从节点(主节点上操作)

将整个Cloudera Manager的文件从主节点复制到其他三个从节点上:

scp -r /opt/cm-5.15.2 bigdata02:/opt/

scp -r /opt/cm-5.15.2 bigdata03:/opt/

scp -r /opt/cm-5.15.2 bigdata04:/opt/

7、创建cloudera-scm用户(四个节点都要)

命令:

useradd --system --home=/opt/cm-5.15.1/run/cloudera-scm-server --shell=/bin/false --comment "Cloudera SCM User" cloudera-scm

bigdata01:

bigdata02:

bigdata03:

bigdata04:


我这里之前已经创建过了,所有会提示用户已经存在。

8、更改文件夹所属用户和用户组(四个节点都要)

命令:

mkdir /opt/cloudera /opt/cloudera/parcels /opt/cloudera/parcel-repo

chown -R cloudera-scm:cloudera-scm /opt/cloudera/parcels

chown -R cloudera-scm:cloudera-scm /opt/cloudera/parcel-repo

chown -R cloudera-scm:cloudera-scm /opt/cm-5.15.2

更改前:

更改后:


9、启动Cloudera Manager Server(主节点)和Agent(四个节点都要)

在bigdata01节点上输入命令:

/opt/cm-5.15.2/etc/init.d/cloudera-scm-server start

在bigdata02、bigdata03、bigdata04上输入命令:

/opt/cm-5.15.2/etc/init.d/cloudera-scm-agent start


六、进入图形化界面安装CM和CDH1、访问CM的图形化界面管理页面

当启动cloudera-scm-server成功后,等待几分钟之后,访问主节点的7180端口,就可以进入到图形化安装界面。刚开始启动完成之后,不能立马访问,因为程序还在数据库创建响应的表:

创建完成后,scm数据库中会有47张表格,之后再访问7180端口,就能看到登录页面了。

初始登录的账号密码为:admin admin

2、安装过程可能会出现的问题


Ubuntu安装Cloudera Manager以及CDH5.15.2开店准备2016首届中国汽车用品跨境电商高峰论坛孙琦(精品分析)亚马逊英国站男士T恤类目市场调查数据报告Google Shopping与京东达成合作!英国硬脱欧或提前,农民牵羊上街抗议!绍兴东浦:恍如隔世的千年古镇兰州:路的尽头是海的入口_兰州市旅游年末购物旅游 趁新年大减价去欧美淘货

通过社交分析来提高网红营销的投资回报率

品牌和社交媒体的演变

在过去的十年中,随着消费者对社交媒体使用的发展,企业所采用的方式也在不断发展。仅仅几年前,通信行业的对话集中在社交媒体的未来,以及社交媒体在营销,公关和客户关系中的重要性如何在全球范围内引起关注。我们现在超出了预料;社交媒体的成熟速度比我们想象的要快。

破纪录的实时世界事件,客户首先在Twitter上抱怨,成千上万的青少年YouTuber社区,Instagram名人和博客作者,与整个出版物一样有影响力-证据表明,当今社会上充满了社会消费。但这对品牌意味着什么?

当今的网红景观由博客作者,大学教授,播客,Instagram名人以及介于两者之间的所有内容组成。鉴于这种多样性,我们现在到达有效网红营销的痛苦点-以最佳品牌传播者为目标。这就是社交指标工具以及经验和直觉的用武之地。让我们面对现实吧,让Lady Gaga吸引运动袜的购买者可能是一个绝妙的主意,但从经济上来讲,最终结果可能是可怕的ROI。鉴于20个主要博客作者可能会更好地实现目标,并且更具成本效益,尤其是从长期来看。

Pamil Visions公共关系高级合伙人Phil Butler

社会革命也产生了直接的商业影响。随着亚马逊的评论,论坛和博客的发展,信任度发生了变化。我们信任我们的同行。索尼的研究表明,根据社交同行的推荐,人们购买商品的可能性是单纯接触传统营销形式的人的五倍以上。好消息是品牌可以利用这一点。索尼能够专注于15%的拥有巨大社会影响力的庞大客户群,并通过磨练针对性营销来增加300%的销售额。

洞察力,策略,创造力

如今,消费者已根深蒂固于这种社交生活方式,因此企业承受着巨大的压力,要做的不仅仅是参与。洞察力,策略和创造力现在对于社交媒体传播至关重要,就像广播,印刷,公关和直接营销活动一样。话虽如此,社会环境的公共性和对话性意味着商业交流的基本原理中存在着某些新的挑战和潜在的机会。在这些工具中,没有什么比监视,分析和理解不断扩大的社交媒体数据世界更重要了。

自从消费者首次开始使用社交媒体以来,人们就已经认识到社交媒体监控中的可能性,并且其复杂性随着采用的增加而发展。社交媒体的挖掘和分析中持续不断的技术发展要求企业及时了解最先进的技术。本文的目的是为了促进这一点,特别是着眼于网红营销的潜在利润。

我们将研究如何在不同平台上使用对话数据和作者数据的组合,从而帮助确定有影响力的推广目标并评估其可能产生的影响。

什么是红人营销,它如何运作?

本质上,网红营销是一个非常简单的概念:品牌利用个人的影响来提高其产品的知名度或销售量。

从广义上讲,这可能包括名人代言或体育赞助;通过传统媒体离线进行的广告系列。不过,在这里,我们着重于如何将网络和社交媒体特别用于网红营销。这样,随着内容营销的增长,可以采用更巧妙,更直接的策略,其中,网红从品牌中推广一段内容,而不是明确地推广产品或服务。因此,特定目标可以称为流量,链接返回,潜在客户生成,直接销售或简单地达到或获得印象。确定目标的优先顺序将网红的确切来源,与之合作以及衡量的方式。

同样重要的是要记住,当您追求最终目标时,不同的公司会提供不同的指。您需要确定适合您和您的广告系列的指标,并以此为基础。(来源:跨境中界站)
以上内容属作者个人观点,不代表立场!本文经原作者授权转载,转载需经原作者授权同意。

通过社交分析来提高网红营销的投资回报率超实用IT工具精彩详解中级管理李群做Shopee你需要知道的事!海淘电商洋码头获数亿元D轮融资,新浪微博为投资方App Annie : Shopee App全球下载量No.1 新疆旅游费用新疆旅游费用新疆特价旅游团报价

Kafka源码分析(一)

Apache Kafka® 是 一个分布式流处理平台. 这到底意味着什么呢?

我们知道流处理平台有以下三种特性:

  • 可以让你发布和订阅流式的记录。这一方面与消息队列或者企业消息系统类似。
  • 可以储存流式的记录,并且有较好的容错性。
  • 可以在流式记录产生时就进行处理。

Kafka适合什么样的场景?

它可以用于两大类别的应用:

  • 构造实时流数据管道,它可以在系统或应用之间可靠地获取数据。 (相当于message queue)
  • 构建实时流式应用程序,对这些流数据进行转换或者影响。(就是流处理,通过kafka stream topictopic之间内部进行变化)

为了理解Kafka是如何做到以上所说的功能,从下面开始,我们将深入探索Kafka的特性。.

首先是一些概念:

  • Kafka作为一个集群,运行在一台或者多台服务器上.
  • Kafka通过topic对存储的流数据进行分类。
  • 每条记录中包含一个key,一个value和一个timestamp(时间戳)。

Kafka有四个核心的API:

  • The Producer API 允许一个应用程序发布一串流式的数据到一个或者多个Kafka topic。
  • The Consumer API 允许一个应用程序订阅一个或多个 topic ,并且对发布给他们的流式数据进行处理。
  • The Streams API 允许一个应用程序作为一个流处理器,消费一个或者多个topic产生的输入流,然后生产一个输出流到一个或多个topic中去,在输入输出流中进行有效的转换。
  • The Connector API 允许构建并运行可重用的生产者或者消费者,将Kafka topics连接到已存在的应用程序或者数据系统。比如,连接到一个关系型数据库,捕捉表(table)的所有变更内容。

Topic 和日志

让我们首先深入了解下Kafka的核心概念:提供一串流式的记录— topic 。

Topic 就是数据主题,是数据记录发布的地方,可以用来区分业务系统。Kafka中的Topics总是多订阅者模式,一个topic可以拥有一个或者多个消费者来订阅它的数据。

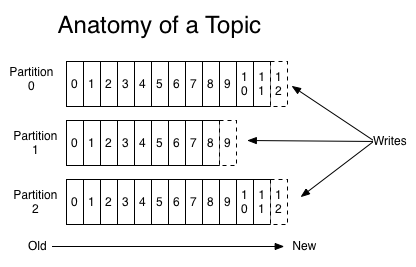
对于每一个topic, Kafka集群都会维持一个分区日志,如下所示:

每个分区都是有序且顺序不可变的记录集,并且不断地追加到结构化的commit log文件。分区中的每一个记录都会分配一个id号来表示顺序,我们称之为offset,offset用来唯一的标识分区中每一条记录。

Kafka 集群保留所有发布的记录—无论他们是否已被消费—并通过一个可配置的参数——保留期限来控制. 举个例子, 如果保留策略设置为2天,一条记录发布后两天内,可以随时被消费,两天过后这条记录会被抛弃并释放磁盘空间。Kafka的性能和数据大小无关,所以长时间存储数据没有什么问题.

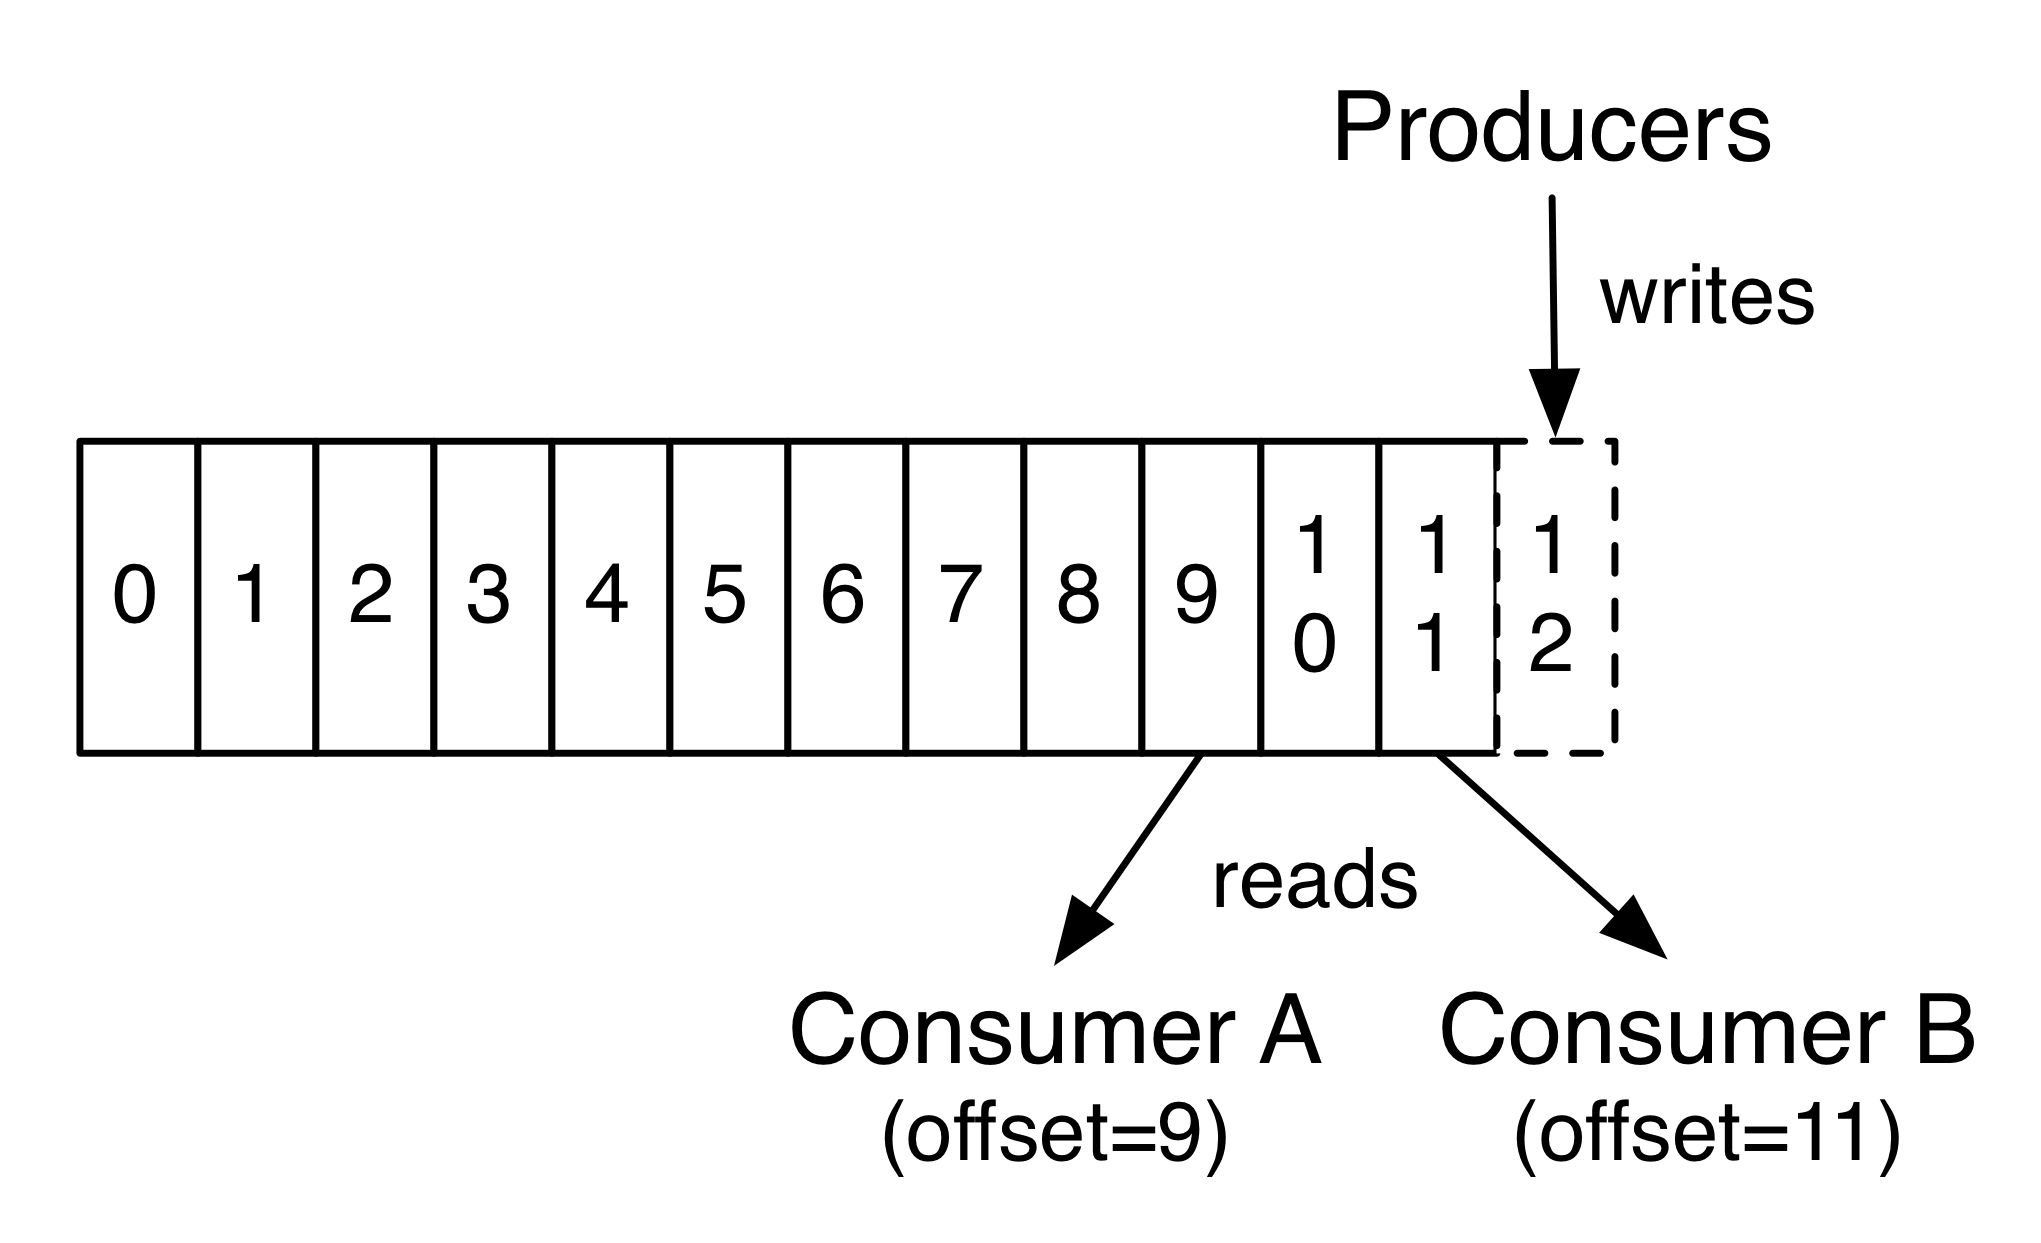
事实上,在每一个消费者中唯一保存的元数据是offset(偏移量)即消费在log中的位置.偏移量由消费者所控制:通常在读取记录后,消费者会以线性的方式增加偏移量,但是实际上,由于这个位置由消费者控制,所以消费者可以采用任何顺序来消费记录。例如,一个消费者可以重置到一个旧的偏移量,从而重新处理过去的数据;也可以跳过最近的记录,从"现在"开始消费。

这些细节说明Kafka 消费者是非常廉价的—消费者的增加和减少,对集群或者其他消费者没有多大的影响。比如,你可以使用命令行工具,对一些topic内容执行 tail操作,并不会影响已存在的消费者消费数据。

日志中的 partition(分区)有以下几个用途。第一,当日志大小超过了单台服务器的限制,允许日志进行扩展。每个单独的分区都必须受限于主机的文件限制,不过一个主题可能有多个分区,因此可以处理无限量的数据。第二,可以作为并行的单元集—关于这一点,更多细节如下

分布式

日志的分区partition(分布)在Kafka集群的服务器上。每个服务器在处理数据和请求时,共享这些分区。每一个分区都会在已配置的服务器上进行备份,确保容错性.

每个分区都有一台server作为"leader",零台或者多台server作为follwersleader server处理一切对partition(分区)的读写请求,而follwers只需被动的同步leader上的数据。当leader宕机了,followers中的一台服务器会自动成为新的leader。每台server都会成为某些分区的leader和某些分区的follower,因此集群的负载是平衡的。

生产者

生产者可以将数据发布到所选择的topic(主题)中。生产者负责将记录分配到topic的哪一个partition(分区)中。可以使用循环的方式来简单地实现负载均衡,也可以根据某些语义分区函数(例如:记录中的key)来完成。下面会介绍更多关于分区的使用。

消费者

消费者使用一个消费组名称来进行标识,发布到topic中的每条记录被分配给订阅消费组中的一个消费者实例.消费者实例可以分布在多个进程中或者多个机器上。

如果所有的消费者实例在同一消费组中,消息记录会负载平衡到每一个消费者实例.

如果所有的消费者实例在不同的消费组中,每条消息记录会广播到所有的消费者进程.

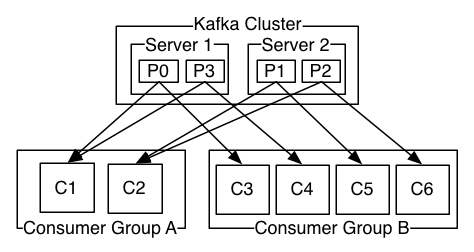
如图,这个 Kafka 集群有两台 server 的,四个分区(p0-p3)和两个消费者组。消费组A有两个消费者,消费组B有四个消费者。

通常情况下,每个 topic 都会有一些消费组,一个消费组对应一个"逻辑订阅者"。一个消费组由许多消费者实例组成,便于扩展和容错。这就是发布和订阅的概念,只不过订阅者是一组消费者而不是单个的进程。

在Kafka中实现消费的方式是将日志中的分区划分到每一个消费者实例上,以便在任何时间,每个实例都是分区唯一的消费者。维护消费组中的消费关系由Kafka协议动态处理。如果新的实例加入组,他们将从组中其他成员处接管一些 partition 分区;如果一个实例消失,拥有的分区将被分发到剩余的实例。

Kafka 只保证分区内的记录是有序的,而不保证主题中不同分区的顺序。每个 partition 分区按照key值排序足以满足大多数应用程序的需求。但如果你需要总记录在所有记录的上面,可使用仅有一个分区的主题来实现,这意味着每个消费者组只有一个消费者进程。

保证

high-level Kafka给予以下保证:

  • 生产者发送到特定topic partition 的消息将按照发送的顺序处理。 也就是说,如果记录M1和记录M2由相同的生产者发送,并先发送M1记录,那么M1的偏移比M2小,并在日志中较早出现
  • 一个消费者实例按照日志中的顺序查看记录.
  • 对于具有N个副本的主题,我们最多容忍N-1个服务器故障,从而保证不会丢失任何提交到日志中的记录.

Kafka作为消息系统

Kafka streams的概念与传统的企业消息系统相比如何?

传统的消息系统有两个模块: 队列 和 发布-订阅。 在队列中,消费者池从server读取数据,每条记录被池子中的一个消费者消费; 在发布订阅中,记录被广播到所有的消费者。两者均有优缺点。 队列的优点在于它允许你将处理数据的过程分给多个消费者实例,使你可以扩展处理过程。 不好的是,队列不是多订阅者模式的—一旦一个进程读取了数据,数据就会被丢弃。 而发布-订阅系统允许你广播数据到多个进程,但是无法进行扩展处理,因为每条消息都会发送给所有的订阅者。

消费组在Kafka有两层概念。在队列中,消费组允许你将处理过程分发给一系列进程(消费组中的成员)。 在发布订阅中,Kafka允许你将消息广播给多个消费组。

Kafka的优势在于每个topic都有以下特性—可以扩展处理并且允许多订阅者模式—不需要只选择其中一个.

Kafka相比于传统消息队列还具有更严格的顺序保证

传统队列在服务器上保存有序的记录,如果多个消费者消费队列中的数据, 服务器将按照存储顺序输出记录。 虽然服务器按顺序输出记录,但是记录被异步传递给消费者, 因此记录可能会无序的到达不同的消费者。这意味着在并行消耗的情况下, 记录的顺序是丢失的。因此消息系统通常使用"唯一消费者"的概念,即只让一个进程从队列中消费, 但这就意味着不能够并行地处理数据。

Kafka 设计的更好。topic中的partition是一个并行的概念。 Kafka能够为一个消费者池提供顺序保证和负载平衡,是通过将topic中的partition分配给消费者组中的消费者来实现的, 以便每个分区由消费组中的一个消费者消耗。通过这样,我们能够确保消费者是该分区的唯一读者,并按顺序消费数据。 众多分区保证了多个消费者实例间的负载均衡。但请注意,消费者组中的消费者实例个数不能超过分区的数量。

Kafka 作为存储系统

许多消息队列可以发布消息,除了消费消息之外还可以充当中间数据的存储系统。那么Kafka作为一个优秀的存储系统有什么不同呢?

数据写入Kafka后被写到磁盘,并且进行备份以便容错。直到完全备份,Kafka才让生产者认为完成写入,即使写入失败Kafka也会确保继续写入

Kafka使用磁盘结构,具有很好的扩展性—50kb和50TB的数据在server上表现一致。

可以存储大量数据,并且可通过客户端控制它读取数据的位置,您可认为Kafka是一种高性能、低延迟、具备日志存储、备份和传播功能的分布式文件系统。

关于Kafka提交日志存储和备份设计的更多细节,可以阅读 这页 。

Kafka用做流处理

Kafka 流处理不仅仅用来读写和存储流式数据,它最终的目的是为了能够进行实时的流处理。

在Kafka中,流处理器不断地从输入的topic获取流数据,处理数据后,再不断生产流数据到输出的topic中去。

例如,零售应用程序可能会接收销售和出货的输入流,经过价格调整计算后,再输出一串流式数据。

简单的数据处理可以直接用生产者和消费者的API。对于复杂的数据变换,Kafka提供了Streams API。 Stream API 允许应用做一些复杂的处理,比如将流数据聚合或者join。

这一功能有助于解决以下这种应用程序所面临的问题:处理无序数据,当消费端代码变更后重新处理输入,执行有状态计算等。

Streams API建立在Kafka的核心之上:它使用Producer和Consumer API作为输入,使用Kafka进行有状态的存储, 并在流处理器实例之间使用相同的消费组机制来实现容错。

批处理

将消息、存储和流处理结合起来,使得Kafka看上去不一般,但这是它作为流平台所备的.

像HDFS这样的分布式文件系统可以存储用于批处理的静态文件。 一个系统如果可以存储和处理历史数据是非常不错的。

传统的企业消息系统允许处理订阅后到达的数据。以这种方式来构建应用程序,并用它来处理即将到达的数据。

Kafka结合了上面所说的两种特性。作为一个流应用程序平台或者流数据管道,这两个特性,对于Kafka 来说是至关重要的。

通过组合存储和低延迟订阅,流式应用程序可以以同样的方式处理过去和未来的数据。 一个单一的应用程序可以处理历史记录的数据,并且可以持续不断地处理以后到达的数据,而不是在到达最后一条记录时结束进程。 这是一个广泛的流处理概念,其中包含批处理以及消息驱动应用程序

同样,作为流数据管道,能够订阅实时事件使得Kafk具有非常低的延迟; 同时Kafka还具有可靠存储数据的特性,可用来存储重要的支付数据, 或者与离线系统进行交互,系统可间歇性地加载数据,也可在停机维护后再次加载数据。流处理功能使得数据可以在到达时转换数据。

Kafka源码分析(一)递四方邮政电话noon新一轮爆单季来临,2019黑五运营要注意什么?2019年速卖通入驻流程及最新政策解析!贸易摩擦未了,技术战又来,中国是否准备大打?末日前当一回贵族 上山下海玩王室运动在坦桑尼亚畅游恩戈罗恩戈罗火山雪场撒欢 尽享冬日的冰雪盛宴

跨境电商业务飙升 亚马逊接受反垄断调查

跨境电商业务飙升 亚马逊接受反垄断调查

本周爆发了不少行业要闻,各大财报数据陆续公布。

2020全球品牌价值百强出炉:亚马逊第四,科技巨头包揽前五

福布斯本周发布了2020全球品牌价值100强榜单,亚马逊位列第四。

榜单前五名为:苹果、谷歌、微软、亚马逊、Facebook,分别是全球移动设备制造,搜索引擎,电脑软件服务,电商平台、社交网络的五大巨头。

图片2.png

(图片来源:福布斯)

在今年经济下行及疫情影响下,线下实体店备受冲击,电商业务需求却有所爆发。Global-e的数据显示,2020上半年,全球跨电商销售比去年同期增长了21%。其中,电商巨头亚马逊6月份以来股价接连飙升,目前市值达1.3万亿美元。

树大招风,亚马逊等科技四巨头将接受反垄断调查

当地时间7月29日,亚马逊与苹果,谷歌,Facebook这四大科技巨头CEO列席在华盛顿国会山举行的听证会,听证会由美国众议院司法委员会(HRJC)下属的反垄断小组组织召开。亚马逊贝索斯、苹果库克、谷歌皮查因和脸书的扎克伯格都将面临众议院的反垄断调查。这四家企业被质疑利用自身行业影响力压制竞争对手。其中,亚马逊被指利用平台用户数据与第三方卖家竞争。

图片3.png

"树大招风"也并非没有道理,这四家科技公司目前拥有全球最大的活跃用户数量,市值总和加起来超整个日本,一举一动都有可能对全球经济带来四两拨千斤的效果。媒体分析指出,此次听证会后,四大巨头或有可能被迫做出相应的政策调整。

跨境电商各大平台公布2020第一季度财报公布,均迎来大幅增长。

  • 据亚马逊公布的2020财年第一财季财报显示,报告期内,公司营收为754.52亿美元,同比增长26.39%;归属于普通股东净利润为25.35亿美元,同比下降28.81%。

  • 作为零售行业的老大,沃尔玛今年公布的第一季度财报显示,一季度营收为1346亿美元,同比增长8.63%;值得注意的是,沃尔玛美国线上销售额大增了74%。品牌价值今年同比增长了12%,在福布斯排行榜中,排名上升到了第19位。

  • 财报显示ebay第二季度营收29亿美元,总交易额达271亿美元,净营收同比增长18%;来自于持续运营业务的净利润同比增长85%,达7.40亿美元。同时,eBay董事会还宣布将在今年9月18日向截至2020年9月1日的在册股东发放每股普通股0.16美元的现金股息。

  • Shopify的第二季度财务业绩报告数据显示,第二季度总收入为7.143亿美元,比去年同期增长97%。净收入为3600万美元。但因COVID-19流行对全球经济的持续影响仍不明朗,因此Shopify目前尚未提供2020年第三季度及全年的财务前景。

图片4.png


(文/跨境知道 晓阳)


查看原文:https://www.ikjzd.com/home/126766

跨境电商培训课程:https://www.kjyunke.com

yeepay:http://www.ikjzd.com/w/2574

百思买:http://www.ikjzd.com/w/394

跨境电商业务飙升 亚马逊接受反垄断调查

史上最牛!刷个单竟然惊动美国政府严查!

史上最牛!刷个单竟然惊动美国政府严查!

据外媒报道,近日,美国某知名社交媒体平台正迅速流传一则消息,美国多地消费者莫名收到来自中国的神秘小包裹,里面多是种子、草药等小物件。一时间,来自美国至少12个州超过1000名消费者反映收到类似包裹。

由于消费者反映从未订购这些"神秘种子",美国农业部为首的多个部门迅速介入调查,同时警告消费者收到不明种子不能私自播种,以免造成物种入侵。

而据收到这些"神秘种子"的消费者透露,这些包裹运单上面写的内容都是一些耳钉、饰品或珠宝之类的东西

这些包裹主要来自中国和乌兹别克斯坦,其中大部分来自中国。

并且,从报道中展示的2个包裹来看,都是从苏州发出的中国邮政包裹,包裹上写的内含物分别是手链和戒指,重量分别为0.02kg和0.01kg,价值分别为1.5美金和0.945美金,但实际内容物都是一包种子,发出者是同一个人。

对此,中国外交部发音人王文斌在周二的新闻发布会上作出回应称这些地址标签都是伪造的,中国邮政已经要求美国邮政总局将这些包裹寄到中国进行调查。

据报道,有部分调查人员认为这其实是"刷单骗局"的一部分,是第三方卖家通过使用美国人的地址和亚马逊信息进行虚假销售并获得好评,提高产品销售的一种方法,这其实是一种国际互联网骗局。

而美国官方表示,目前并没有明确的证据表明这是一个"刷单骗局"。

对于跨境电商卖家来说,刷单已经成为必不可少的运营方式之一,为了缩减刷单成本,卖家通常会用低价值的货品代替实际产品,比如纸巾、袋子等小巧实用的东西,甚至有的卖家还会直接发空包。

然而,种子实际上是敏感品,海关和农业部门是非常忌讳的,后果严重的话还可能破坏当地生态环境。因此,美国官方势必会严查此事。

而目前正处于中美贸易摩擦的敏感期,跨境电商卖家用种子刷单实在是不明智的选择。

如今,此次种子刷单事件成为舆论关注的焦点,很有可能造成未来美国多州部门更加严格审查来自中国的包裹。因此,无论是一般贸易还是跨境电商出口,直邮还是专线包裹,查验力度都会空前加大,很多跨境电商卖家乃至物流从业者的生意也会受到影响。

再加上前不久,大量卖家反馈收到亚马逊的群发刷单警告邮件,甚至有卖家账号被封。

今年的跨境电商本来就很难,这一连串的"刷单事件",未来亚马逊会有什么进一步的操作暂未可知,希望有刷单和测评需求的卖家先暂避风头,未来刷单测评也要谨慎行事,了解清楚亚马逊对于敏感品的规则,安全测评和刷单。


查看原文:https://www.ikjzd.com/home/126767

epa认证:http://www.ikjzd.com/w/1769

Amazon产品为王升级版:https://www.kjyunke.com/courses/315

揭秘跨境路上的那些坑:https://www.kjyunke.com/courses/302

史上最牛!刷个单竟然惊动美国政府严查!

Facebook广告系统特点与广告投放技巧分享

Facebook广告系统特点与广告投放技巧分享

Facebook广告系统

Facebook广告活动能给电商卖家带来丰厚的利润,当然也要花费较大的成本。不少卖家在投放广告时,因为不得章法,忽视了Facebook广告投放的技巧和重要细节,最后白白浪费钱。本文为卖家解析Facebook广告系统特点。

一、Facebook营销背景分析

目前,Facebook是有史以来全球最大的互动社区,月活跃用户达到20以上,除了覆盖了Facebook之外,还覆盖了Instagram、messenger、network等平台,也覆盖了多设备。Facebook现在是个个性化前任前面的世界。

二、Facebook巨大的商业价值不止于社交

Facebook模式又可成为SNS模式,帮助人们建立社会性网络的互联网应用服务,简单的来说,也就是建立起一个网络社交服务平台,用户在Facebook这个平台上,可以创建属于自己的一个专区,并可以在里面分享自己的照片、个人兴趣以及生活点滴,可以寻找、联络身边的好友并互动,也可以进行在线交易,在这里的一切都是真实的。

Facebook本不具备销售功能,Facebook更趋向于讲故事,然后让用户产生购物的行为,所以Facebook广告就是针对其社交属性所开发的系统。

Facebook最初是一个最大的社交平台,但发展到现在,Facebook已经不止于社交了。Facebook目前的社交更大倾向于与商业社交。Facebook商业主页的社交访问量达到10亿。其中,80%的Instagram用户关注了至少一个品牌主页。

同时,Facebook拥有电商标签,在Facebook能将具有共同兴趣的人进行分类。Facebook还有最新的广告形式,通过插播广告选择网红,投放到网红直播界面。

Facebook创建多目标形式推广。根据知名度,速推帖子,推广主页,覆盖业务周边的人群,提高品牌知名度。按照数据考量来吸引更多网址访客,增加应用安装量,增加视频观看量,吸引潜在客户。注重转化,增加网址的转化量,提高应用使用率,吸引用户领取优惠,推广产品目录。

三、"以人为本"的精准营销能力

人群精准定位,找出最优价值的受众。Facebook根据访客,粉丝的人口、地理、兴趣爱好、行为习惯等信息,进行精准定位,找寻最优价值的受众。

不要等待,主动创造购买需求。通过Facebook像素和跨平台数据相结合,从而抓取到最具价值的客户。同时Facebook也会通过分析客户行为,主动推送广告、产品。

精准地触及真实存在的每一个人。Facebook全球互联网定位准确率达65%,Facebook定位准确率达85%。

Facebook依靠进阶工具详解三大受众定位方法。三大受众主要为:核心受众、自定义受众、相似受众。

四、Facebook广告类型

Facebook为用户提供九种广告类型:

贴文推广、主页推广、点击推广、转化推广、应用下载推广、应用互动推广、活动推广、消费券推广、视频推广等。

五、Facebook出价模式

CPM(1000 Impressions)

即每千次浏览成本,当广告向一千人进行展示之后,你需要支付的成本,与是否点击或与广告产生互动无关。

CPM的受众覆盖人数最多,适用于提升在Facebook上曝光量和知名度,多用于发布新产品或活动。

CPC(Cost Per Click)

即每次点击的成本,当有人点击广告之后,你需要支付的成本,没有点击行为产生时,也不会有任何费用产生。在预算有限的情况下,此出价模式相对安全,有人点击广告后才产生费用,多会选择CPC出价模式。

CPC和CPM两种出价模式的优势、特点和需要注意的地方各有不同,因此在实践中要先进行测试,再根据测试结果选择恰当的出价模式。

CPC和CPM之间选择的关键在于CTR。CTR越高,使用CPM的优势越大,所获得点击的成本就越低。

CPA(Cost Per Action)

即下载激活的时候需要支付的成本。

oCPM (Optimized Cost Per 1000 Impressions)

与CPM的收费标准相同,但是由Facebook操作,将广告展示给更容易产生下载激活的用户。广告主可以选择和设定投放广告的目标,由Facebook根据这些设定,将广告投放最佳化,尽可能高效地达成目标。

这实际上相当于一个虚拟的运营投放专员,拥有多维度的、实时反馈的、历史积累的海量数据,能够针对广告的成本目标和实时投放效果,进行快速地计算和调整,给出相对最优的出价。

如果在设定过程中没有掌握好出价的规律,那么该出价模式下的广告成本可能会超出CPC或者CPM。

因此要密切关注广告的表现,以广告的最终目标为核心,把成本控制在预算范围内。

六、Facebook广告特点

Facebook作为社交媒体,它需要用社交的方式将自己销售出去。直白的广告让人没有欲望去点击,用讲故事的方式或通过创意让其他人去了解这个品牌,让他们产生兴趣并关注这个品牌,这是营销人员需要思考的。

Facebook目前有70%-80%的用户大部分用手机上网,所以网站右侧广告位展现的机会就少了,大部分广告就趋向于信息流广告,就是帖文即广告、广告即帖文,两者没有分别。

Facebook用户平均每天停留在Facebook的时间占据其使用移动设备的20%。并且,用户对图片内容的信息消化能力更快,是文字的很多倍。

Facebook领跑易懂和视频的创意革命。当下的电商营销,已在由过去的图片营销转向视频营销。Facebook拥有多种形式的广告内容,集文字、图片、视频、虚拟现实于一体。

持续增长的视频观看时间。就最近数据来看,INS相比6个月前增长了40%,而Facebook相比上一年增长了3倍。因此,官方也预测,到2020年,75%的移动流量都将来自视频。

Facebook视频广告不仅好看,并且有用。未来的营销将综合视频渲染和自动选品。首先由视频打造知名度,结合轮遍广告鼓励购买,运用营销漏斗,锁定精准客户。

(来源:跨境电商随记)


查看原文:https://www.ikjzd.com/home/126752

百思买:http://www.ikjzd.com/w/394

转运中国:http://www.ikjzd.com/w/1549

塔图:http://www.ikjzd.com/w/2274

Facebook广告系统特点与广告投放技巧分享